Лекция 5. Потоки, синхронизация и GIL#
План#
Потоки одного процесса: запуск, ожидание, завершение и общая память.
Синхронизация:
Event,Barrier,Lock,RLock,Condition,Semaphore,queue.Queue,threading.local.Пул потоков:
ThreadPoolExecutor, результаты и исключения черезFuture.GIL: вычисления и ожидание ввода-вывода,
race conditionиdata race, дедлоки и лайвлоки.
Часть I. Потоки и синхронизация#
От частоты к числу ядер#
Долгое время последовательные программы ускорялись почти без изменений: в новых поколениях процессоров росла тактовая частота и улучшалась архитектура ядра. Это можно представить как рост «по вертикали»: одна последовательность команд выполняется быстрее.
Закон Мура — эмпирическое наблюдение за развитием микросхем: в распространённой формулировке число транзисторов на кристалле примерно удваивается каждые два года. Дополнительные транзисторы можно использовать для кешей, усложнения ядра или новых ядер; выигрыш в скорости зависит от того, как программа использует эти возможности.
Но повышать частоту всё труднее: растут энергопотребление и нагрев, а тепло нужно отводить. Поэтому важным направлением стало увеличение числа ядер — рост «по горизонтали» внутри процессора. Производительность одного ядра тоже продолжает расти, но дополнительные ядра позволяют выполнять больше работы одновременно.
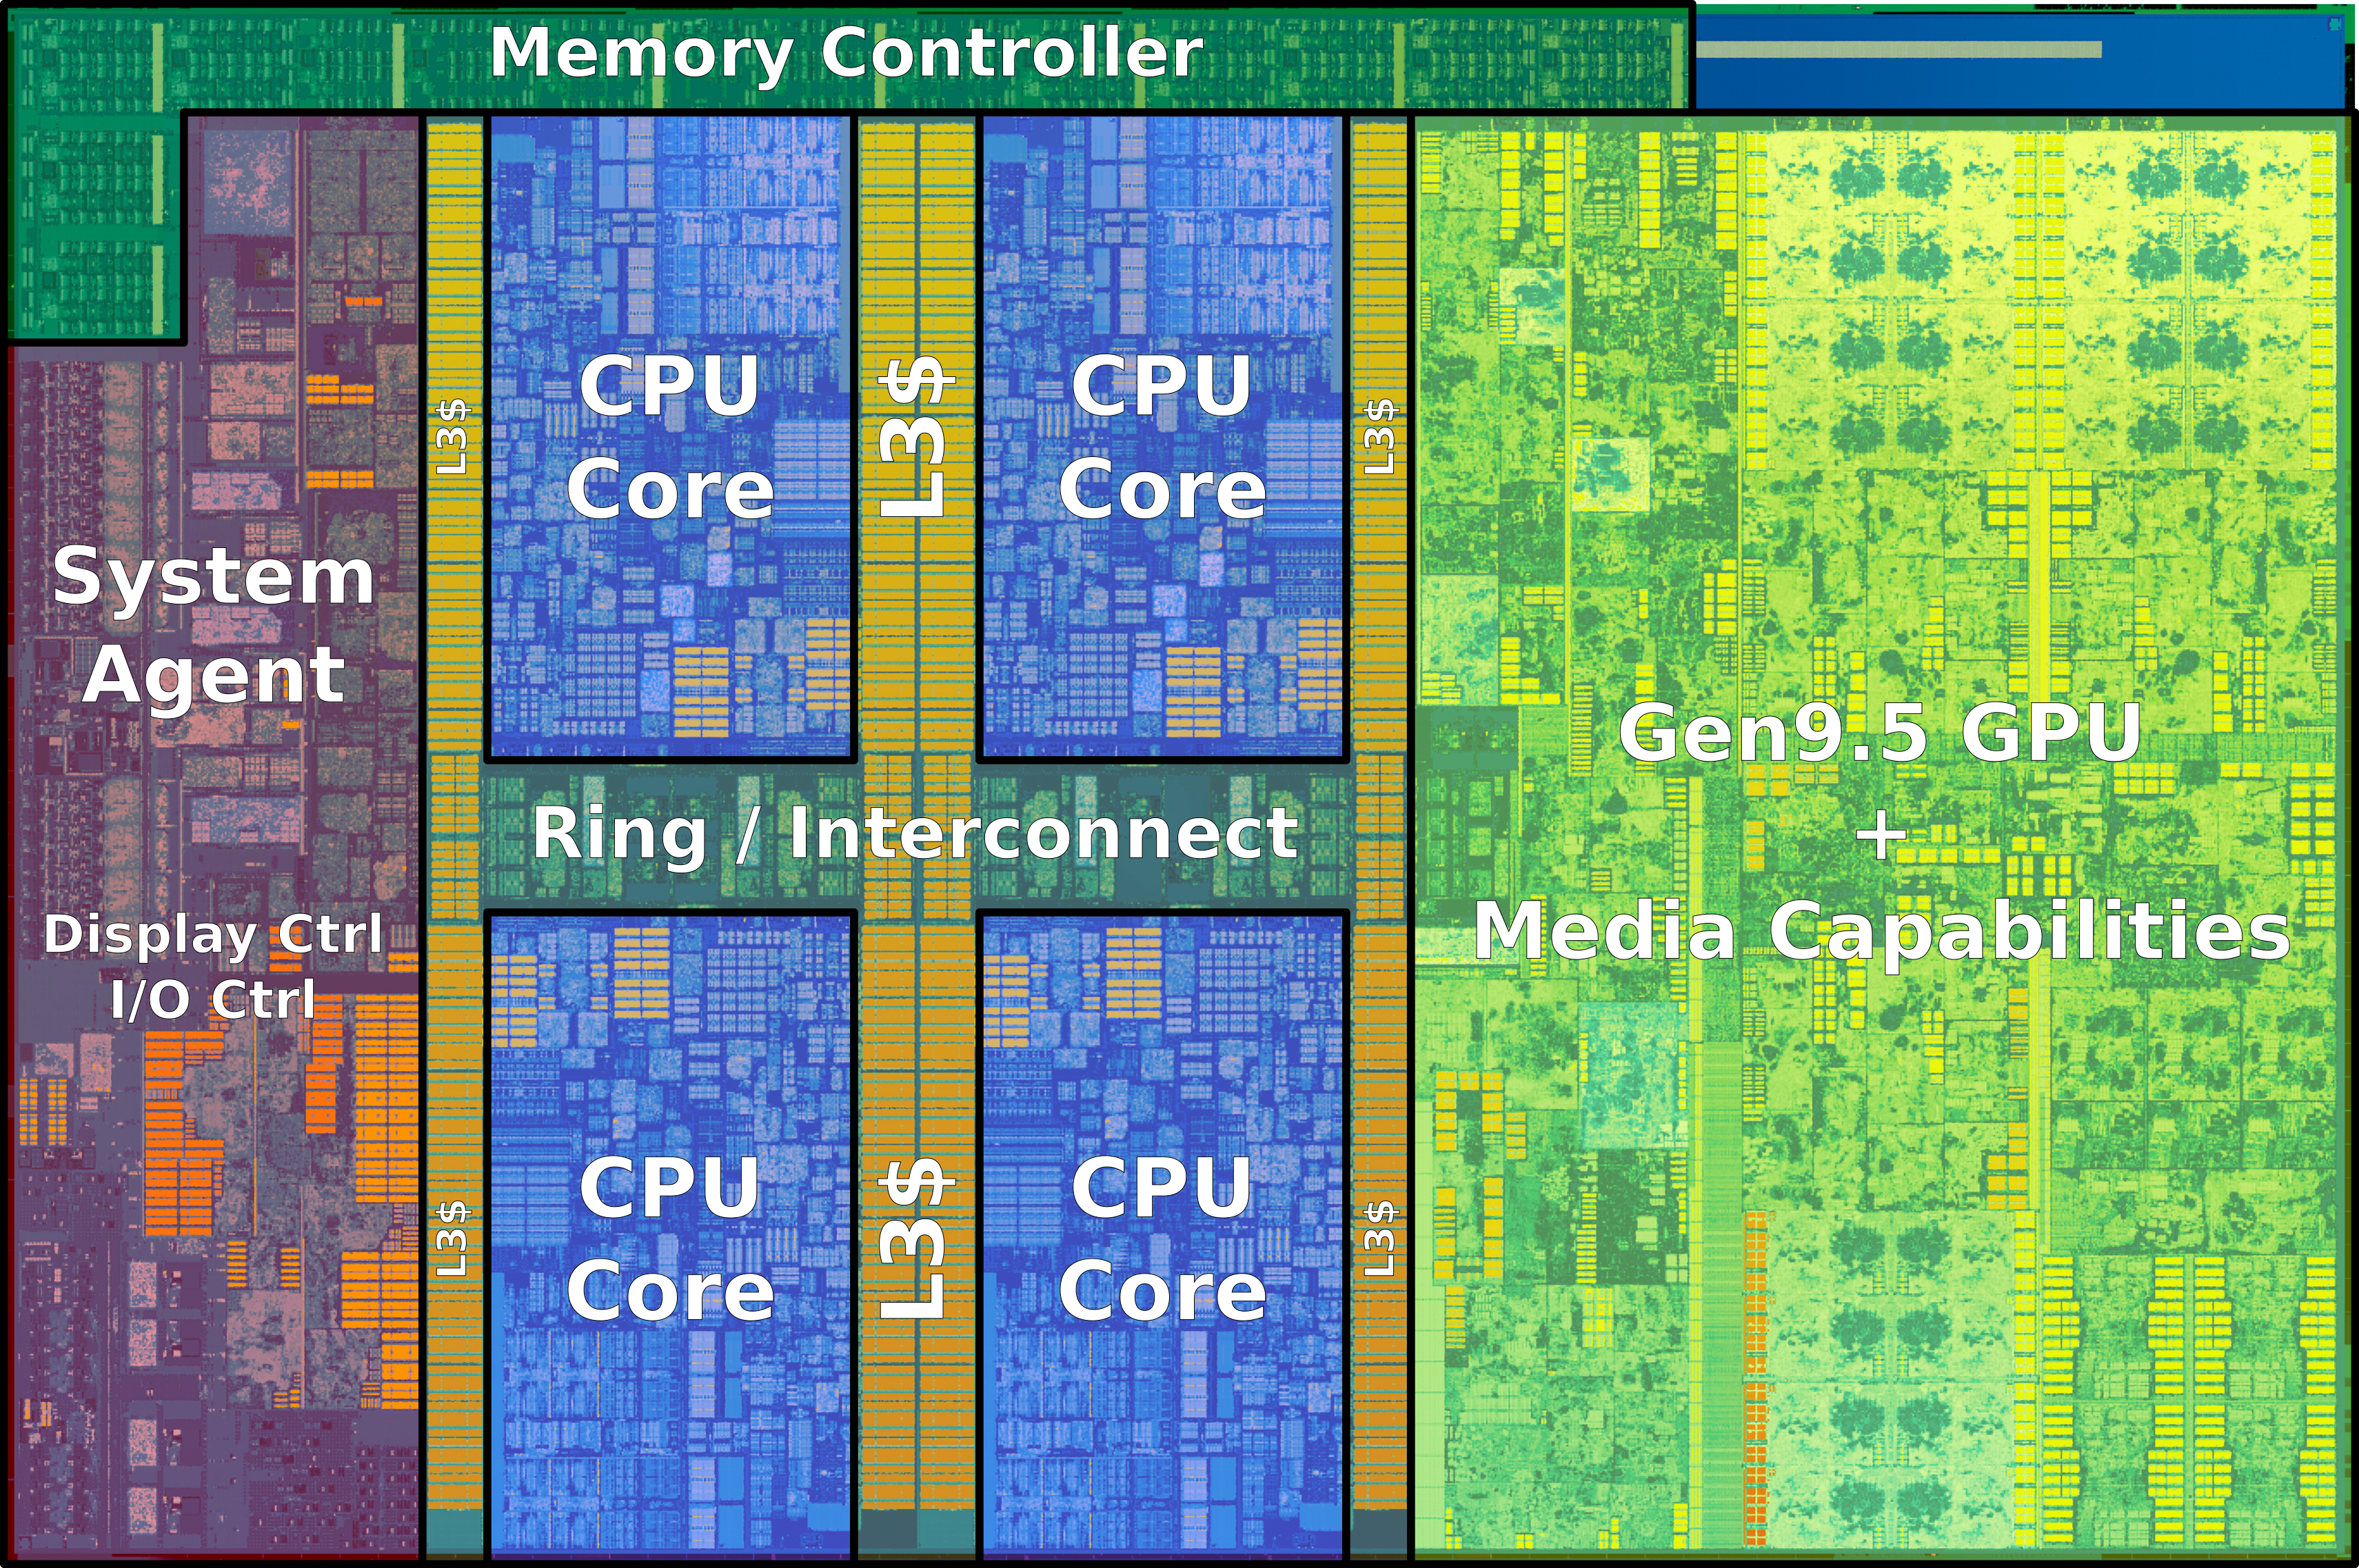
Так выглядит кристалл четырёхъядерного Intel Kaby Lake:
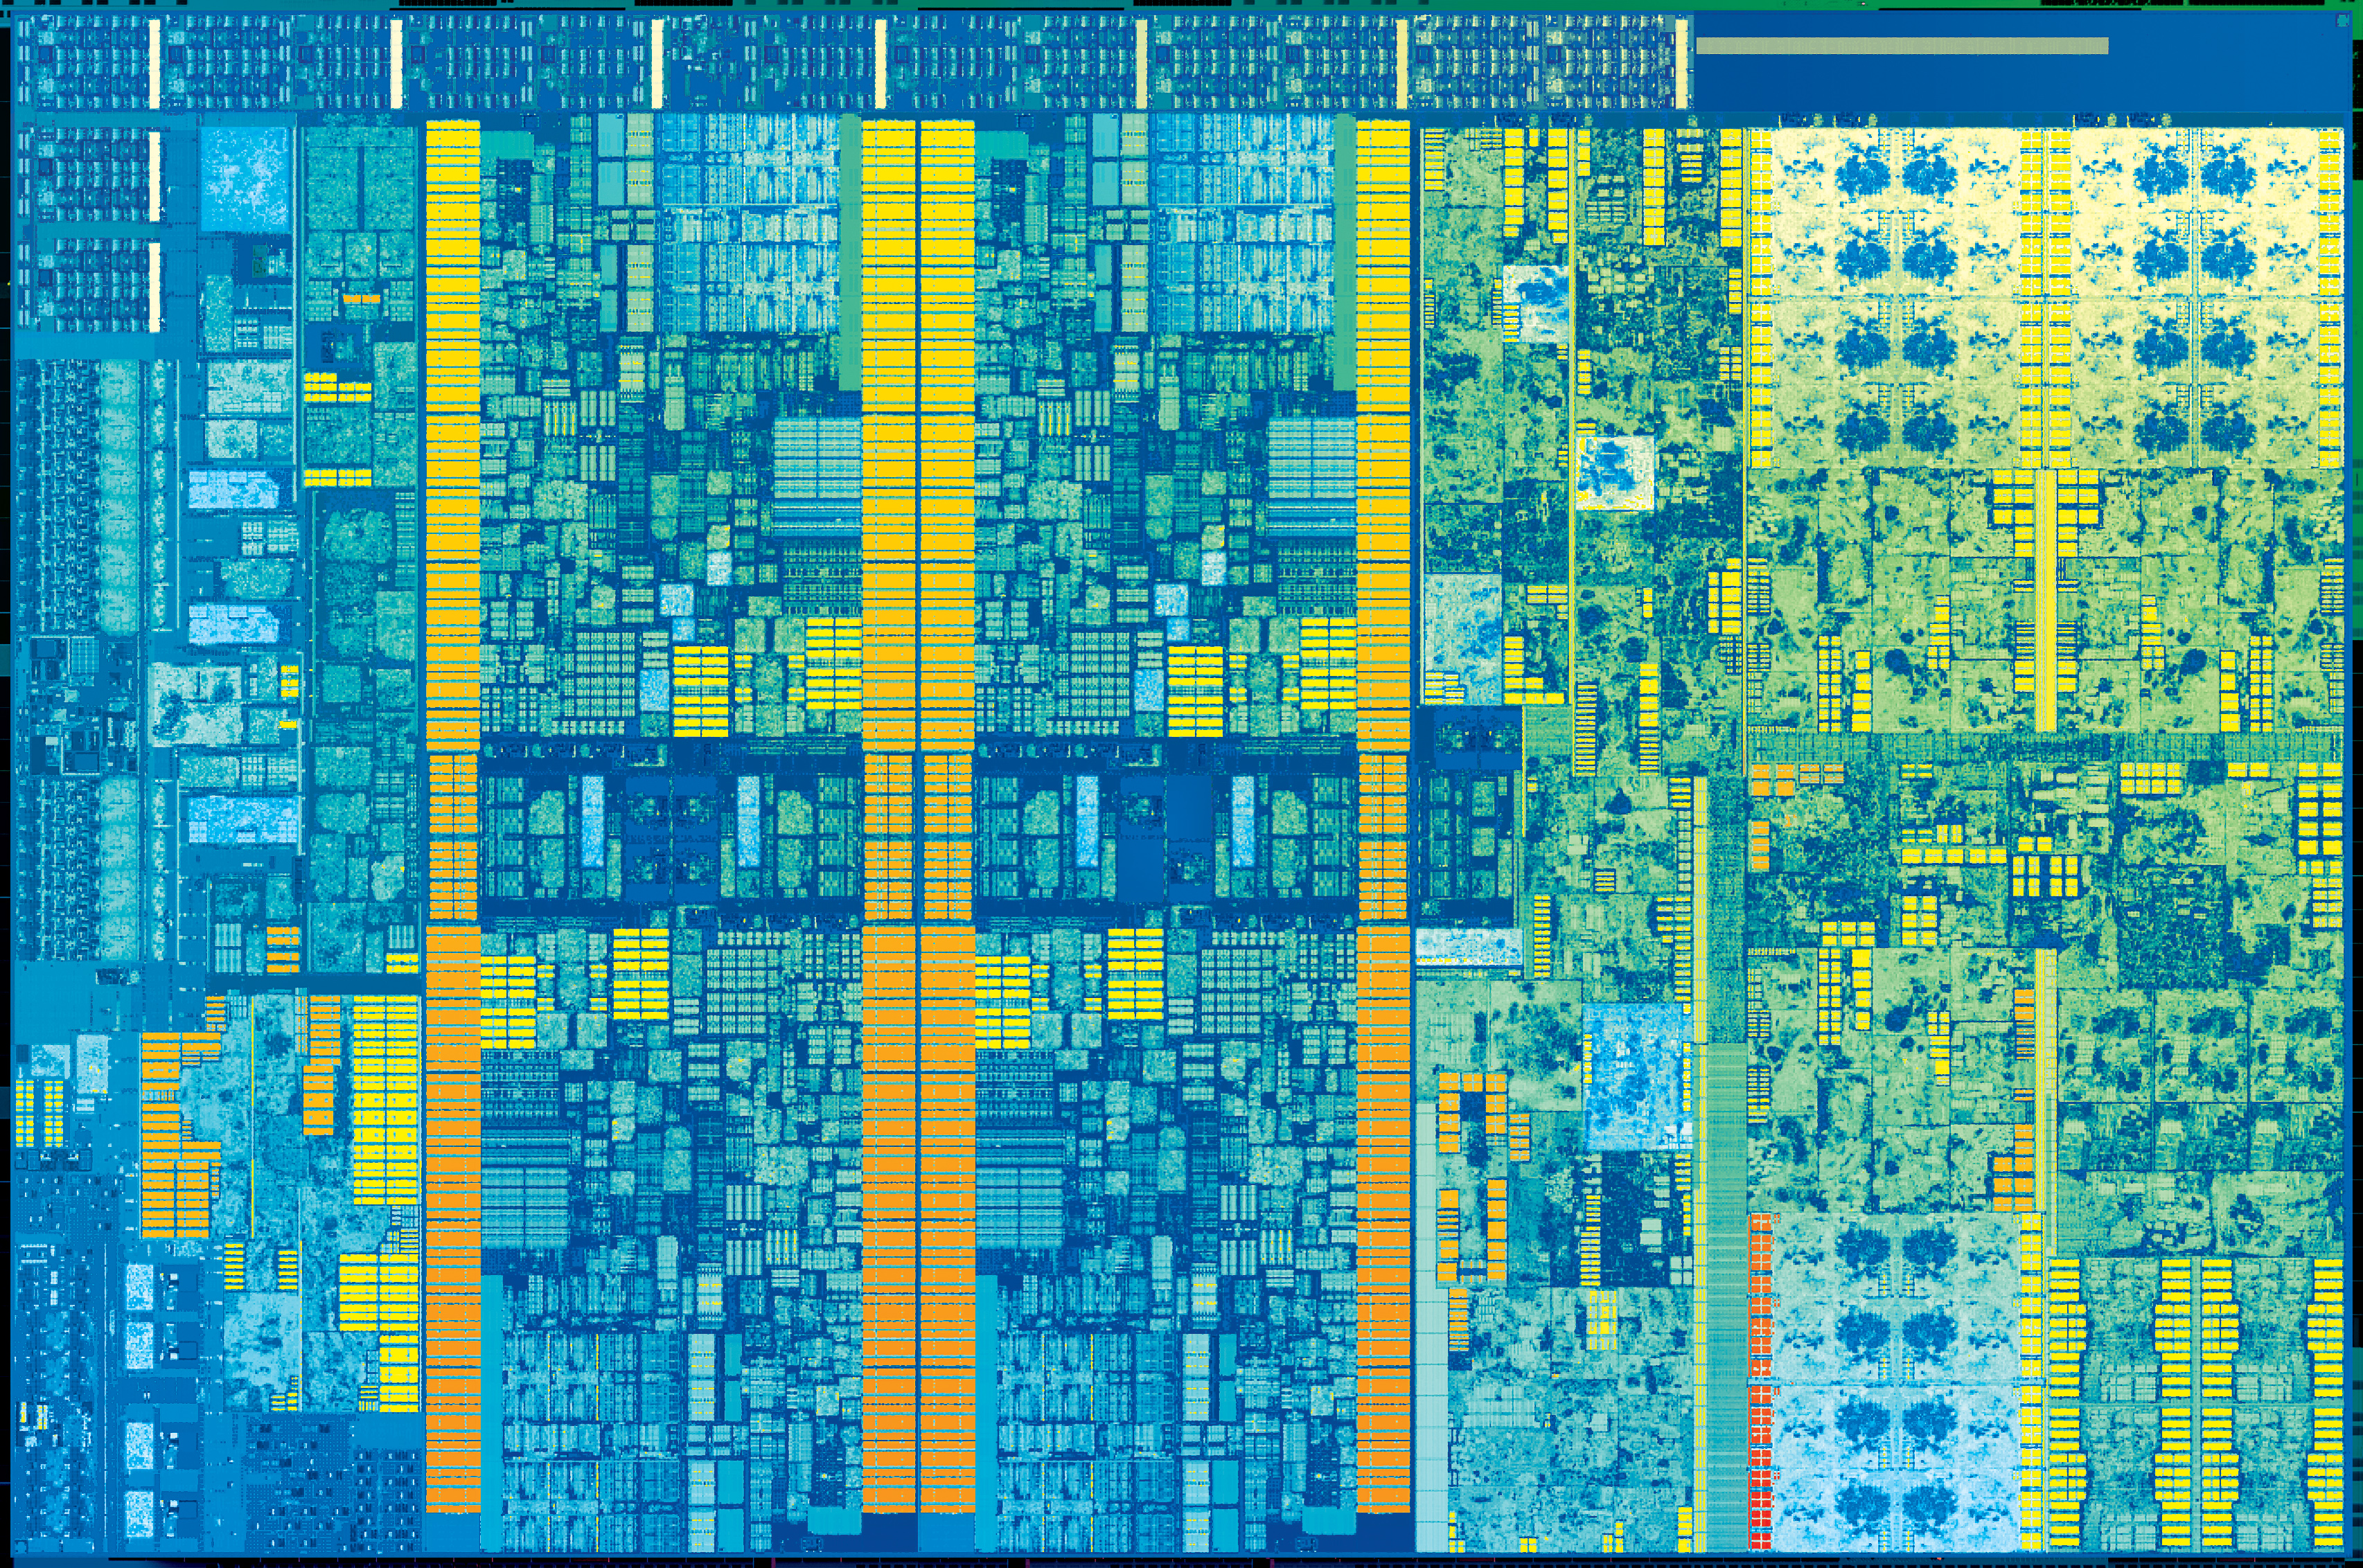
Транзисторы образуют все эти блоки:
Как менялись процессоры за несколько десятилетий?
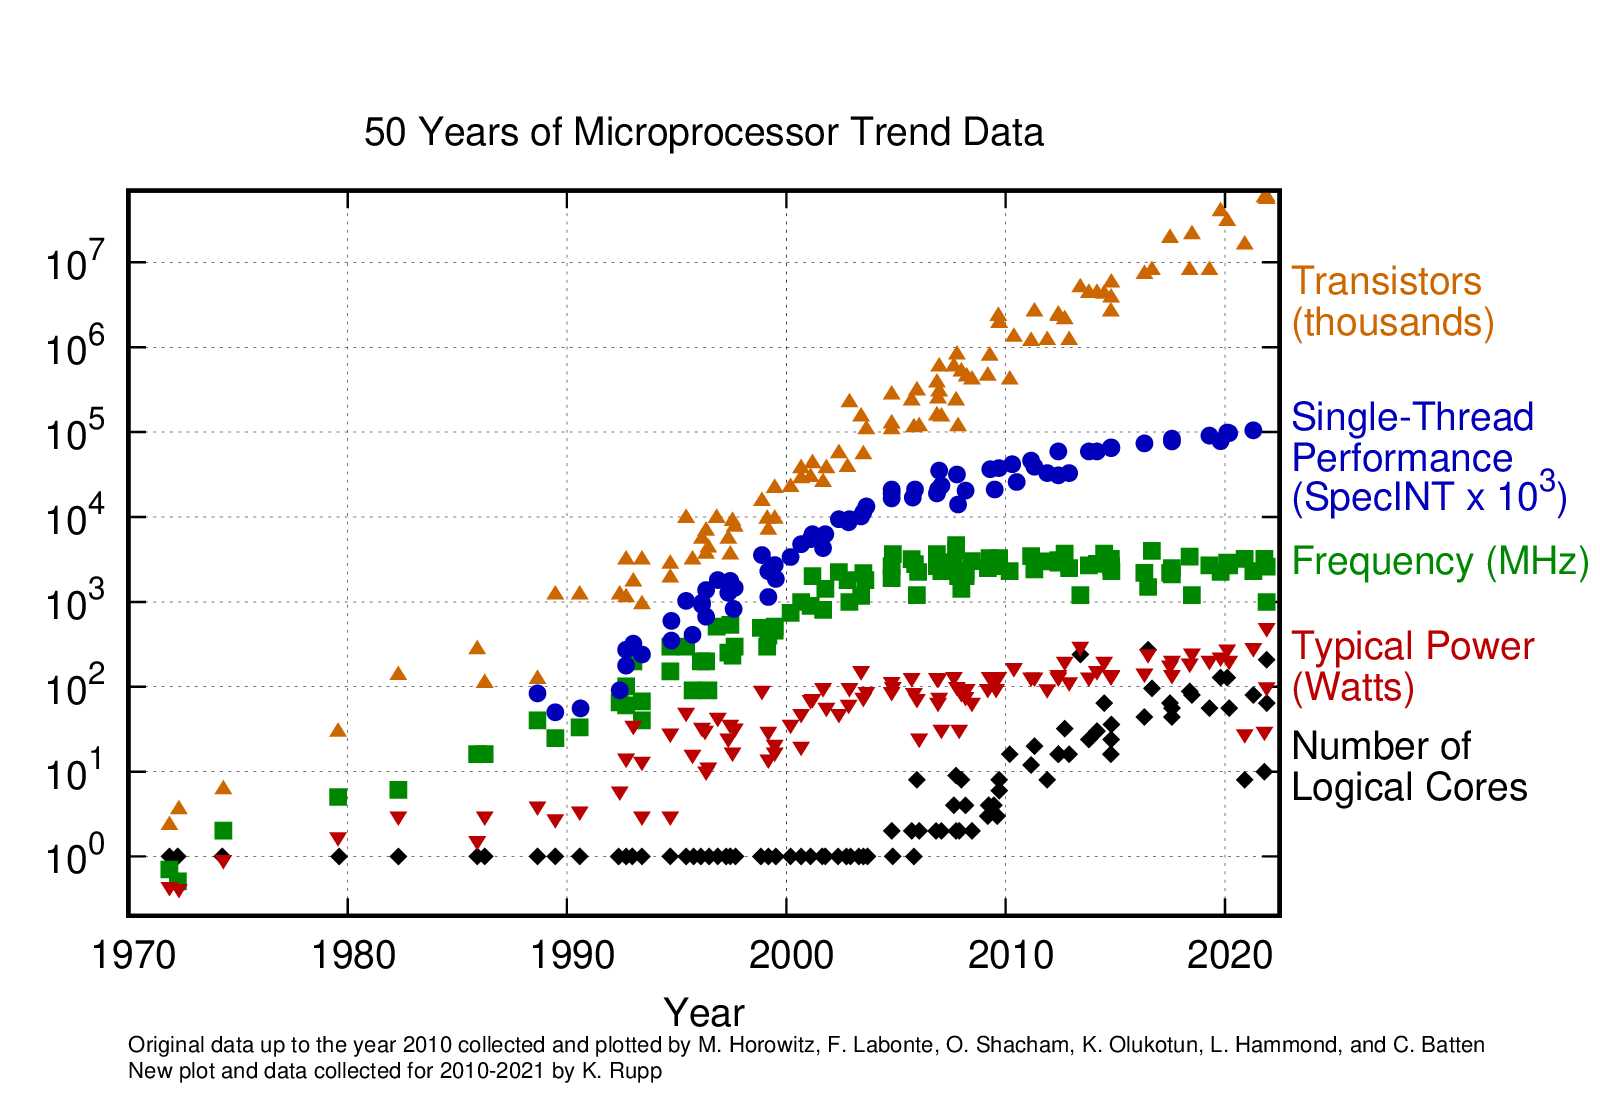
На графике оранжевые точки — число транзисторов, зелёные — тактовая частота, чёрные — число логических ядер. Вертикальная шкала логарифмическая: каждый шаг вверх означает увеличение в десять раз. Данные за 1970–2021 годы.
Для программы это меняет условия: восемь ядер сами по себе не ускоряют один последовательный цикл в восемь раз. Чтобы использовать несколько ядер, программа должна выделить части работы, которые можно выполнять параллельно, и организовать их выполнение.
Для этого языки программирования и их библиотеки предоставляют интерфейсы:
создание потоков и процессов, запуск джоб в пулах. Начнём с потоков:
в Python для них есть threading.Thread.
Что такое поток#
Поток — отдельная последовательность выполнения внутри процесса.
Адресное пространство и ресурсы процесса общие, а стек и состояние
выполнения у каждого потока свои. Проверим, что threading.Thread создаёт
настоящие потоки ОС. В target передаём функцию, а в args — её аргументы.
Метод start() запускает поток, join() ждёт его завершения:
import os
import threading
import time


def show_ids(who: str) -> None:
    print(f"{who:6}  pid={os.getpid()}  tid={threading.get_native_id()}")
    time.sleep(0.05)


show_ids("main")
threads = [threading.Thread(target=show_ids, args=(name,)) for name in ("A", "B")]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join()
main    pid=32610  tid=27690298
A       pid=32610  tid=27690348
B       pid=32610  tid=27690349
У главного и обоих рабочих потоков один pid, но разные tid:
они относятся к одному процессу, а ОС планирует их выполнение отдельно.
Сколько ядер процессора видит Python? При SMT (Simultaneous Multithreading,
одновременная многопоточность) одно физическое ядро
предоставляет ОС несколько аппаратных потоков. У Intel эта технология
называется Hyper-Threading. Например, 4 физических ядра с 2 аппаратными
потоками на каждом видны как 8 логических ядер — именно их считает
os.cpu_count().
print("Логических ядер в системе:", os.cpu_count())
print("Доступно текущему процессу:", os.process_cpu_count())
Логических ядер в системе: 12
Доступно текущему процессу: 12
Аппаратные потоки процессора и потоки Python — разные уровни. Число потоков программы выбираем под задачу: при ожидании ввода-вывода оно зависит от задержек, доступных ресурсов и ограничений внешнего сервиса.
Конкурентность и параллелизм#
ОС может чередовать выполнение нескольких потоков на одном ядре или выполнять их на разных ядрах. Возможность одновременного выполнения зависит и от реализации языка; ограничения CPython разберём при обсуждении GIL.
При конкурентном выполнении (concurrency) периоды работы задач перекрываются: одна задача уже началась, другая ещё не закончилась. Их шаги могут чередоваться. Параллелизм (parallelism) означает, что задачи исполняются одновременно.

Для задачи CPU-bound узкое место — вычисления: например, обработка изображения или перебор вариантов. Для I/O-bound — ожидание сети или диска; пока один запрос ждёт ответ, можно обслуживать другой.
Thread — запуск и ожидание#
start() запускает target в новом потоке и возвращает управление, не дожидаясь
его завершения. Запустим оба потока, затем дождёмся каждого через join():
import threading
import time


def worker(name: str, delay: float) -> None:
    print(f"[{name}] начало")
    time.sleep(delay)
    print(f"[{name}] завершён через {delay} с")


t1 = threading.Thread(target=worker, args=("A", 0.3))
t2 = threading.Thread(target=worker, args=("B", 0.1))

start = time.perf_counter()
t1.start()
t2.start()
t1.join()
t2.join()
print(f"Общее время: {time.perf_counter() - start:.2f} с")
[A] начало
[B] начало
[B] завершён через 0.1 с
[A] завершён через 0.3 с
Общее время: 0.31 с
Время близко к максимальной задержке 0.3, а не к сумме 0.4.
Порядок вывода задаётся расписанием потоков, поэтому рассчитывать на него нельзя.
Результаты работы потоков#
Возвращаемое значение target не сохраняется в Thread, а join()
только ждёт завершения и возвращает None. Каждый рабочий поток запишет
результат в свой элемент общего списка:
results: list[int | None] = [None, None]


def calculate_square(index: int, value: int) -> None:
    results[index] = value * value


threads = [
    threading.Thread(target=calculate_square, args=(index, value))
    for index, value in enumerate((6, 7))
]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join()
print(results)
[36, 49]
После обоих join() функции завершились, и главный поток может прочитать оба
результата. Сразу после start() в списке ещё мог оставаться None.
Главный поток завершился — что будет с остальными?#
После завершения главного потока процесс продолжает работать, пока остаётся
хотя бы один незавершённый поток с daemon=False. Потоки с daemon=True
не задерживают завершение процесса: если остались только они, процесс завершается.
Для демонстрации нужен отдельный процесс:
%%writefile /tmp/thread_daemon_demo.py
import sys
import threading
import time


def slow(name: str) -> None:
    time.sleep(0.2)
    print(f"Поток {name} завершил работу", flush=True)


threads = [
    threading.Thread(target=slow, args=(name,), daemon=sys.argv[1] == "daemon")
    for name in ("A", "B")
]
for thread in threads:
    thread.start()
print("Главный поток завершён", flush=True)
Writing /tmp/thread_daemon_demo.py
!python /tmp/thread_daemon_demo.py daemon
!python /tmp/thread_daemon_demo.py regular
Главный поток завершён
Главный поток завершён
Поток A завершил работу
Поток B завершил работу
В первом запуске рабочие потоки не успевают закончить. Во втором процесс ждёт
обоих: после сообщения главного потока появятся сообщения от A и B.
По умолчанию поток наследует признак
daemon у создающего потока; у главного потока этот признак выключен.
daemon=True не заменяет корректное завершение.
При завершении процесса такой поток может оборваться посередине действия.
Код очистки в блоке finally может не успеть закрыть файл,
дописать данные или освободить блокировку.
Чтобы дать потоку закончить работу, передай сигнал остановки и дождись
его завершения через join().
Исключение в потоке#
Исключение из target обрабатывает threading.excepthook: по умолчанию он
печатает трейсбек в stderr. join() ждёт завершения, но это исключение
в вызывающий поток не переносит:
def broken() -> None:
    raise ValueError("Ошибка в рабочем потоке")


def working() -> None:
    time.sleep(0.05)
    print("Второй рабочий поток завершил работу")


threads = [threading.Thread(target=broken), threading.Thread(target=working)]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join()
print("Главный поток продолжил работу")
Exception in thread Thread-11 (broken):
Traceback (most recent call last):
  File "/opt/homebrew/Cellar/python@3.14/3.14.8_2/Frameworks/Python.framework/Versions/3.14/lib/python3.14/threading.py", line 1082, in _bootstrap_inner
    self._context.run(self.run)
    ~~~~~~~~~~~~~~~~~^^^^^^^^^^
  File "/opt/homebrew/Cellar/python@3.14/3.14.8_2/Frameworks/Python.framework/Versions/3.14/lib/python3.14/threading.py", line 1024, in run
    self._target(*self._args, **self._kwargs)
    ~~~~~~~~~~~~^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
  File "/var/folders/db/8q3n6yxn6l32mz6r0frxg7v40000gn/T/ipykernel_32610/1479536827.py", line 2, in broken
    raise ValueError("Ошибка в рабочем потоке")
ValueError: Ошибка в рабочем потоке
Второй рабочий поток завершил работу
Главный поток продолжил работу
Исключение завершило один рабочий поток. Второй и главный продолжили работу; само завершение потока ещё не означает, что его функция выполнилась успешно.
Event — общий флаг для сигналов#
Event хранит флаг: set() устанавливает его и будит всех ожидающих.
Пока флаг установлен, новые вызовы wait() тоже проходят сразу.
import threading

ready = threading.Event()

def waiter(name: str) -> None:
    print(f"[{name}] ждёт")
    ready.wait()
    print(f"[{name}] продолжает работу")

threads = [threading.Thread(target=waiter, args=(name,)) for name in ("A", "B")]
for t in threads:
    t.start()

print("Главный поток: можно начинать")
ready.set()
for t in threads:
    t.join()
[A] ждёт
[B] ждёт
Главный поток: можно начинать
[B] продолжает работу
[A] продолжает работу
Флаг многоразовый: clear() сбрасывает его. wait(timeout=...) возвращает
False, если ожидание истекло без сигнала:
print("После set:", ready.is_set(), ready.wait(timeout=0))
ready.clear()
print("После clear:", ready.is_set(), ready.wait(timeout=0.05))
ready.set()
print("После повторного set:", ready.wait(timeout=0))
После set: True True
После clear: False False
После повторного set: True
Event не считает сигналы: два вызова set() оставят тот
же установленный флаг. Для уведомления «конфиг загружен» или «пора завершаться»
этого достаточно. Если важно обработать каждую джобу, одного флага недостаточно.
Таймаут ожидания и сигнал остановки#
join(timeout=...) ограничивает ожидание, но не останавливает поток.
Метод is_alive() показывает, продолжает ли поток работу после ожидания.
Передадим обоим рабочим потокам один Event как сигнал остановки:
stop = threading.Event()


def background(name: str) -> None:
    print(f"Поток {name} начал работу")
    stop.wait()
    print(f"Поток {name} получил сигнал остановки")


threads = [threading.Thread(target=background, args=(name,), name=name) for name in ("A", "B")]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join(timeout=0.05)
    print(f"После таймаута поток {thread.name} ещё работает:", thread.is_alive())
stop.set()
for thread in threads:
    thread.join()
    print(f"После сигнала поток {thread.name} ещё работает:", thread.is_alive())
Поток A начал работу
Поток B начал работу
После таймаута поток A ещё работает: True
После таймаута поток B ещё работает: True
Поток A получил сигнал остановки
Поток B получил сигнал остановки
После сигнала поток A ещё работает: False
После сигнала поток B ещё работает: False
Один общий Event передал сигнал обоим потокам. Каждый сам завершил свою функцию,
а главный дождался обоих через join(). Произвольный Thread нельзя принудительно
остановить через публичный API threading.
daemon=True и код в finally#
Проверим предупреждение про очистку ресурсов. Два потока откроют по файлу,
а в finally допишут строку и закроют его. Отдельный Event подтвердит,
что каждый поток уже вошёл в try, прежде чем главный сможет завершиться:
%%writefile /tmp/thread_daemon_cleanup.py
import sys
import threading
from pathlib import Path

stop = threading.Event()


def background(name: str, started: threading.Event) -> None:
    log = Path(f"/tmp/thread_cleanup_{name}.txt").open("w", encoding="utf-8")
    try:
        log.write("Начало работы\n")
        log.flush()
        started.set()
        stop.wait()
        log.write("Получен сигнал остановки\n")
    finally:
        log.write("Выполнен finally\n")
        log.close()


threads: list[threading.Thread] = []
for name in ("A", "B"):
    started = threading.Event()
    thread = threading.Thread(target=background, args=(name, started), daemon=True)
    thread.start()
    assert started.wait(timeout=2.0), f"Поток {name} не успел начать работу"
    threads.append(thread)

if sys.argv[1] == "graceful":
    stop.set()
    for thread in threads:
        thread.join()

print("Главный поток завершён", flush=True)
Writing /tmp/thread_daemon_cleanup.py
Сначала завершим главный поток, оставив оба рабочих ждать сигнал:
!python /tmp/thread_daemon_cleanup.py abrupt

from pathlib import Path

for name in ("A", "B"):
    print(f"Файл потока {name}:")
    print(Path(f"/tmp/thread_cleanup_{name}.txt").read_text(encoding="utf-8"), end="")
Главный поток завершён
Файл потока A:
Начало работы
Файл потока B:
Начало работы
В обоих файлах только «Начало работы»: строка из finally не записалась.
flush() перед ожиданием нужен, чтобы первая строка дошла до файла ещё при работе потока.
Теперь тем же потокам с daemon=True передадим сигнал остановки и дождёмся обоих:
!python /tmp/thread_daemon_cleanup.py graceful

for name in ("A", "B"):
    print(f"Файл потока {name}:")
    print(Path(f"/tmp/thread_cleanup_{name}.txt").read_text(encoding="utf-8"), end="")
Главный поток завершён
Файл потока A:
Начало работы
Получен сигнал остановки
Выполнен finally
Файл потока B:
Начало работы
Получен сигнал остановки
Выполнен finally
Каждый файл теперь содержит все три строки. finally выполняется при выходе
из try, а завершение процесса не разворачивает стек оставшихся daemon-потоков.
Сигнал и join() дали обоим завершить функцию до выхода главного потока.
Для фоновой работы, требующей очистки ресурсов, обычно выбирают daemon=False
и явно организуют остановку — как советует документация Thread.
Barrier — дождаться остальных потоков#
Barrier(N) — точка встречи для N участников. Каждый вызывает wait()
и ждёт, пока туда не придут остальные; после этого все могут продолжить работу.
Один барьер можно использовать многократно: здесь два потока дожидаются друг друга
после каждой из двух фаз:
import threading
import time

N = 2
barrier = threading.Barrier(N)

def worker(idx: int) -> None:
    for phase in range(2):
        time.sleep(0.05 * (N - idx))
        print(f"Фаза {phase}, поток {idx}: готов")
        participant = barrier.wait()
        print(f"Фаза {phase}, поток {idx}: прошёл, индекс {participant}")
        if participant == 0:
            print(f"Все участники дошли до барьера фазы {phase}")

threads = [threading.Thread(target=worker, args=(i,)) for i in range(N)]
for t in threads:
    t.start()
for t in threads:
    t.join()
Фаза 0, поток 1: готов
Фаза 0, поток 0: готов
Фаза 0, поток 0: прошёл, индекс 1
Фаза 0, поток 1: прошёл, индекс 0
Все участники дошли до барьера фазы 0
Фаза 1, поток 1: готов
Фаза 1, поток 0: готов
Фаза 1, поток 0: прошёл, индекс 1
Фаза 1, поток 1: прошёл, индекс 0
Все участники дошли до барьера фазы 1
Для каждой фазы оба сообщения «готов» появятся до любого сообщения «прошёл».
wait() возвращает каждому участнику различное целое число в range(N) для
данного прохода. Это позволяет поручить одному участнику служебную работу;
номер фазы храним отдельно, как phase в примере.
Число участников задаём точно: с Barrier(3) два потока будут ждать третьего.
Ожидание можно ограничить через Barrier(N, timeout=...) или wait(timeout=...).
При истечении таймаута барьер становится сломанным: ожидающие и последующие
вызовы wait() получают threading.BrokenBarrierError.
Документация Barrier.
Для измерения параллельной работы барьер помогает собрать участников у общей точки старта. Он не гарантирует, что ОС начнёт выполнять все потоки в один момент.
Lock (mutex)#
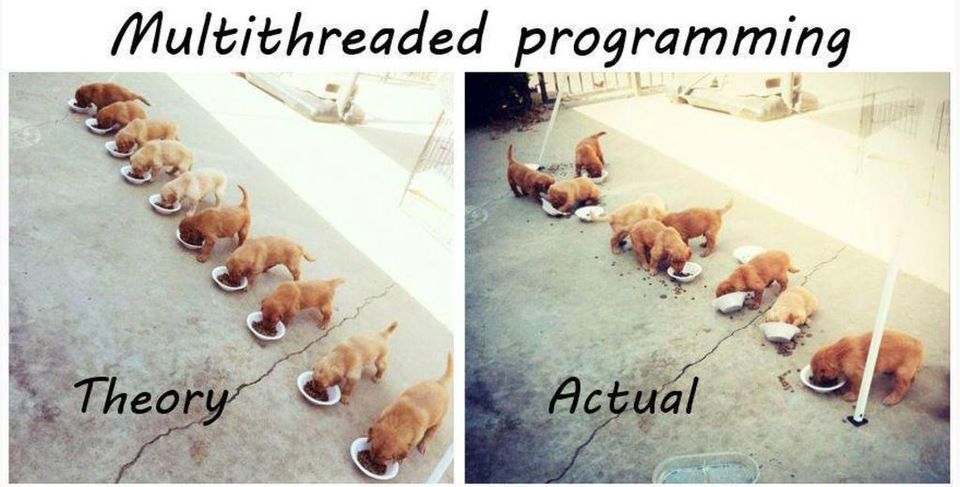
Щенки едят одновременно в обеих половинах картинки. Справа они ещё и мешают друг другу у общих мисок: так же потоки могут конкурировать за общие данные. Чтобы согласовать доступ, понадобятся примитивы синхронизации. Источник копии мема.
Два потока используют общий счётчик. В CPython 3.14 с включённым GIL этот
короткий пример с обычным int обычно выводит 2: увеличение числа потоков
само по себе не заставляет интерпретатор переключиться между чтением и записью.
Удачный вывод ещё не доказывает корректность:
count = 0


def counter() -> None:
    global count
    count += 1


threads = [threading.Thread(target=counter) for _ in range(2)]
for t in threads:
    t.start()
for t in threads:
    t.join()
print("Счётчик:", count)
Счётчик: 2
Посмотрим на инструкции, из которых состоит инкремент:
import dis


dis.dis(counter)
  4           RESUME                   0

  6           LOAD_GLOBAL              0 (count)
              LOAD_SMALL_INT           1
              BINARY_OP               13 (+=)
              STORE_GLOBAL             0 (count)
              LOAD_CONST               1 (None)
              RETURN_VALUE
Чтение, сложение и запись — разные шаги. Но границы инструкций не означают, что CPython обязан переключить поток между любыми двумя из них: сам список инструкций не показывает, где возможно переключение и потеряется ли обновление.
Покажем потерю обновлений без барьера: разделим чтение и запись паузой, как при ожидании ввода-вывода. Каждый из двух потоков попробует увеличить счётчик 100 раз:
count = 0
increments = 100


def counter() -> None:
    global count
    for _ in range(increments):
        old = count
        time.sleep(0.001)
        count = old + 1


threads = [threading.Thread(target=counter) for _ in range(2)]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join()
print(f"Ожидали {2 * increments}, получили: {count}")
Ожидали 200, получили: 100
Обычно получаем около 100 вместо 200. Пока один поток спит после чтения,
второй может прочитать то же значение: затем оба запишут одинаковое новое.
Точный результат зависит от расписания; sleep() не гарантирует порядок потоков.
Теперь применим барьер, чтобы воспроизвести потерянное обновление на 16 потоках.
Поместим wait() между чтением и записью: все прочитают старое значение до
того, как любой из них начнёт запись:
count = 0
n_threads = 16
read_done = threading.Barrier(n_threads)


def counter() -> None:
    global count
    old = count
    read_done.wait()
    count = old + 1


threads = [threading.Thread(target=counter) for _ in range(n_threads)]
for t in threads:
    t.start()
for t in threads:
    t.join()
print(f"Ожидали {n_threads}, получили: {count}")
Ожидали 16, получили: 1
Все 16 потоков прочитали 0 и записали 1: потерялись 15 обновлений.
Это race condition: результат зависит от взаимного порядка операций.
Барьер здесь специально задаёт неудачное
расписание; в прикладном коде похожую паузу может создать ввод-вывод.
Исправляем общей блокировкой. Под ней находятся и чтение, и запись:
count = 0
lock = threading.Lock()


def counter() -> None:
    global count
    with lock:
        old = count
        time.sleep(0.01)  # даже при паузе другой поток не войдёт
        count = old + 1


threads = [threading.Thread(target=counter) for _ in range(n_threads)]
for t in threads:
    t.start()
for t in threads:
    t.join()
print("После синхронизации:", count)
После синхронизации: 16
Блокировкой защищаем всю операцию: чтение значения, проверку ограничения
и изменение данных. Участок кода под блокировкой называют критической секцией.
Все участники должны использовать одну и ту же блокировку.
Долгое ожидание внутри неё задерживает остальные потоки;
здесь sleep оставлен специально для демонстрации.
RLock — повторный захват тем же потоком#
RLock позволяет владельцу захватить блокировку несколько раз. Это нужно,
когда функция под блокировкой вызывает другую функцию, которая берёт её же.
import threading

lock = threading.RLock()
counter = 0

def increment() -> None:
    global counter
    with lock:
        counter += 1

def double_increment(name: str) -> None:
    with lock:
        increment()  # повторный захват тем же потоком
        increment()
        print(f"Поток {name}: counter = {counter}")

threads = [threading.Thread(target=double_increment, args=(name,)) for name in ("A", "B")]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join()
print(f"counter = {counter}")
Поток A: counter = 2
Поток B: counter = 4
counter = 4
Каждый поток увеличил счётчик дважды; итог — 4. С обычным Lock первый вызов
increment() ждал бы освобождения блокировки,
которую держит тот же поток. Посмотрим на владельца и глубину захвата в repr объекта
RLock в CPython:
print(lock)
with lock:
    print(lock)
    with lock:
        print(lock)
    print(lock)
print(lock)
<unlocked _thread.RLock object owner=0 count=0 at 0x107942210>
<locked _thread.RLock object owner=8361173376 count=1 at 0x107942210>
<locked _thread.RLock object owner=8361173376 count=2 at 0x107942210>
<locked _thread.RLock object owner=8361173376 count=1 at 0x107942210>
<unlocked _thread.RLock object owner=0 count=0 at 0x107942210>
Владелец и счётчик захватов отличают RLock от Lock.
На каждый успешный acquire() нужен release() в том же
потоке; другие потоки смогут войти, когда счётчик станет равен нулю.
Вложенные with соблюдают это автоматически.
Condition — ждать условия над общими данными#
Condition объединяет блокировку и ожидание: wait() освобождает блокировку
на время ожидания и захватывает её перед возвратом. Проверку состояния и его
изменение выполняем под одной блокировкой:
import threading
import time
from collections import deque

buffer: deque[int | None] = deque()
cond = threading.Condition()

def producer() -> None:
    for i in range(5):
        with cond:
            buffer.append(i)
            print(f"Добавлено {i}")
            cond.notify()
        time.sleep(0.05)
    with cond:
        buffer.extend([None, None])  # по сигналу завершения на поток
        cond.notify_all()

def consumer() -> None:
    while True:
        with cond:
            while not buffer:
                cond.wait()
            item = buffer.popleft()
        if item is None:
            return
        print(f"[{threading.current_thread().name}] получено {item}")

consumers = [threading.Thread(target=consumer, name=f"C{i}") for i in range(2)]
for t in consumers:
    t.start()
producer()
for t in consumers:
    t.join()
Добавлено 0
[C0] получено 0
Добавлено 1
[C1] получено 1
Добавлено 2
[C0] получено 2
Добавлено 3
[C1] получено 3
Добавлено 4
[C0] получено 4
Главный поток добавляет элементы, два рабочих забирают их из буфера.
None сообщает каждому рабочему потоку, что новых элементов больше не будет.
wait(), notify() и notify_all() требуют захваченной блокировки, иначе
получим RuntimeError. notify() будит одного ожидающего, notify_all() — всех,
но блокировку они получат только после выхода уведомляющего потока из with.
Проверка — в while, даже если каждый сигнал отправлен правильно.
Между notify() и повторным захватом блокировки другой
consumer мог забрать элемент. Пробуждение означает «проверь условие
снова», а не «можно брать элемент».
Метод wait_for(predicate, timeout=None) ждёт, пока функция predicate()
вернёт True; проверку и расчёт оставшегося таймаута он повторяет сам.
Посмотрим его реализацию:
import inspect

print(inspect.getsource(threading.Condition.wait_for))
    def wait_for(self, predicate, timeout=None):
        """Wait until a condition evaluates to True.

        predicate should be a callable which result will be interpreted as a
        boolean value.  A timeout may be provided giving the maximum time to
        wait.

        """
        endtime = None
        waittime = timeout
        result = predicate()
        while not result:
            if waittime is not None:
                if endtime is None:
                    endtime = _time() + waittime
                else:
                    waittime = endtime - _time()
                    if waittime <= 0:
                        break
            self.wait(waittime)
            result = predicate()
        return result
В примере можно заменить цикл на cond.wait_for(lambda: bool(buffer)).
Semaphore#
Семафор хранит счётчик разрешений: acquire() ждёт ненулевого значения и
уменьшает его; release() увеличивает. Здесь одновременно загружаются не больше
двух файлов:
import threading
import time

sem = threading.Semaphore(2)

def download(url: str) -> None:
    with sem:
        print(f"Начало: {url}")
        time.sleep(0.5)
        print(f"Готово: {url}")

threads = [threading.Thread(target=download, args=(f"url-{i}",)) for i in range(4)]
start = time.perf_counter()
for t in threads:
    t.start()
for t in threads:
    t.join()
print(f"Прошло: {time.perf_counter() - start:.2f} с")
Начало: url-0
Начало: url-1
Готово: url-0Готово: url-1

Начало: url-3
Начало: url-2
Готово: url-2
Готово: url-3
Прошло: 1.01 с
Четыре загрузки по 0.5 секунды с двумя разрешениями занимают примерно 1.0
секунду: две начинаются сразу, ещё две ждут освобождения разрешений.
Семафор ограничивает число операций одновременно.
BoundedSemaphore дополнительно запрещает поднять счётчик выше начального
значения. Так обнаруживается лишний release():
bounded = threading.BoundedSemaphore(1)
bounded.release()  # разрешение не было захвачено
---------------------------------------------------------------------------
ValueError                                Traceback (most recent call last)
Cell In[26], line 2
      1 bounded = threading.BoundedSemaphore(1)
----> 2 bounded.release()  # разрешение не было захвачено

File /opt/homebrew/Cellar/python@3.14/3.14.8_2/Frameworks/Python.framework/Versions/3.14/lib/python3.14/threading.py:586, in BoundedSemaphore.release(self, n)
    584 with self._cond:
    585     if self._value + n > self._initial_value:
--> 586         raise ValueError("Semaphore released too many times")
    587     self._value += n
    588     self._cond.notify(n)

ValueError: Semaphore released too many times
queue.Queue — очередь между потоками#
queue.Queue поддерживает несколько producer и несколько consumer — это
MPMC (Multiple Producer, Multiple Consumer). Элементы извлекаются в порядке
добавления (FIFO, First In, First Out). Метод get()
ждёт элемент, put() — место в очереди, если задан maxsize. В этом примере
None обозначает конец джоб. После обработки каждого элемента вызываем
task_done(). Метод q.join() ждёт таких отметок для всех добавленных элементов:
import threading
import queue
import time

q: queue.Queue[int | None] = queue.Queue(maxsize=2)

def producer() -> None:
    for i in range(5):
        q.put(i)
        print(f"Добавлено {i}")
    q.put(None)
    q.put(None)

def consumer() -> None:
    while True:
        item = q.get()
        try:
            if item is None:
                return
            time.sleep(0.1)
            print(f"[{threading.current_thread().name}] обработано {item}")
        finally:
            q.task_done()

consumers = [threading.Thread(target=consumer, name=f"C{i}") for i in range(2)]
for thread in consumers:
    thread.start()
producer()
q.join()  # каждая джоба отмечена как обработанная
for thread in consumers:
    thread.join()
print("Очередь обработана")
Добавлено 0
Добавлено 1
Добавлено 2
Добавлено 3
[C0] обработано 0[C1] обработано 1
Добавлено 4
[C1] обработано 2
[C0] обработано 3
[C1] обработано 4
Очередь обработана
Здесь один producer работает в главном потоке, а два consumer — в рабочих: это сценарий SPMC на очереди, которая поддерживает MPMC. Очерёдность извлечения элементов сохраняется, но обработка может завершиться в другом порядке.
Классификация очередей
По числу участников: producer добавляет элементы, consumer извлекает.
S означает Single (один), M — Multiple (несколько).
Обозначение |
Producer |
Consumer |
Расшифровка |
|---|---|---|---|
SPSC |
Один |
Один |
Single Producer, Single Consumer |
SPMC |
Один |
Несколько |
Single Producer, Multiple Consumer |
MPSC |
Несколько |
Один |
Multiple Producer, Single Consumer |
MPMC |
Несколько |
Несколько |
Multiple Producer, Multiple Consumer |
По порядку извлечения элементов:
Класс |
Порядок |
|---|---|
|
FIFO: первым извлекается первый добавленный элемент |
|
LIFO (Last In, First Out): первым извлекается последний добавленный элемент |
|
Первым извлекается минимальный элемент; часто используют пары |
|
FIFO; упрощённый API без |
По вместимости: maxsize > 0 ограничивает число элементов, находящихся в очереди.
Когда она заполнена, put() ждёт свободного места. При maxsize <= 0 такого
ограничения нет. SimpleQueue тоже не ограничивает вместимость.
Эти свойства независимы: FIFO описывает порядок извлечения, MPMC — допустимое
число producer и consumer. Все четыре класса модуля queue поддерживают
нескольких producer и consumer. Документация queue
На каждый put() нужен один task_done(), включая
сигнал завершения None. Если пропустить его,
q.join() продолжит ждать даже после завершения потока.
Блок finally вызывает task_done() и при выходе через
return, и при ошибке во время обработки элемента.
Ожидание можно ограничить: put(..., timeout=N) выбросит queue.Full,
get(timeout=N) — queue.Empty. Методы put_nowait() и get_nowait() не ждут.
Размер из qsize() нельзя использовать как гарантию, что следующий get()
или put() пройдёт без ожидания: другой поток мог уже изменить очередь.
threading.local — отдельные атрибуты для каждого потока#
Один объект threading.local имеет отдельный словарь атрибутов в каждом потоке.
Посмотрим на него через vars():
import threading

data = threading.local()
data.x = "главный поток"

def worker(value: int) -> None:
    name = threading.current_thread().name
    print(f"[{name}] до присваивания: {vars(data)}")
    data.x = value
    print(f"[{name}] после присваивания: {vars(data)}")

threads = [threading.Thread(target=worker, args=(i,), name=f"T{i}") for i in range(2)]
for t in threads:
    t.start()
for t in threads:
    t.join()
print("В главном потоке:", vars(data))
[T0] до присваивания: {}[T1] до присваивания: {}
[T1] после присваивания: {'x': 1}

[T0] после присваивания: {'x': 0}
В главном потоке: {'x': 'главный поток'}
Так можно хранить данные текущего потока, например идентификатор запроса, который нужен нескольким функциям.
Если один поток последовательно обрабатывает несколько джоб, атрибуты
threading.local сохраняются между ними. Данные нужно обновлять
или очищать перед каждой джобой.
Часть II. Пул потоков и результаты#
ThreadPoolExecutor переиспользует потоки для множества джоб и ограничивает
их число через max_workers. map() выдаёт результаты в порядке входных данных:
from concurrent.futures import ThreadPoolExecutor
import time

def fetch_url(url: str) -> str:
    time.sleep(0.2)  # имитация сетевого запроса
    return f"{url} -> 200 OK"

urls = [f"https://example.com/page{i}" for i in range(4)]

start = time.perf_counter()
with ThreadPoolExecutor(max_workers=2) as pool:
    results = list(pool.map(fetch_url, urls))
elapsed = time.perf_counter() - start

print(*results, sep="\n")
print(f"4 запроса через 2 потока: {elapsed:.2f} с")
https://example.com/page0 -> 200 OK
https://example.com/page1 -> 200 OK
https://example.com/page2 -> 200 OK
https://example.com/page3 -> 200 OK
4 запроса через 2 потока: 0.41 с
Последовательно четыре запроса заняли бы примерно 0.8 секунды; с двумя
потоками — 0.4. При выходе из with пул ждёт завершения отправленных джоб.
Future — результат отдельной джобы#
submit() ставит джобу в пул и возвращает объект Future, через который
можно получить результат. Метод result() ждёт завершения джобы;
as_completed() выдаёт объекты Future по мере завершения их джоб:
from concurrent.futures import ThreadPoolExecutor, as_completed
import time

def work(item: int) -> int:
    time.sleep(0.1 * (item % 3 + 1))
    return item * item

with ThreadPoolExecutor(max_workers=2) as pool:
    futures = {pool.submit(work, i): i for i in range(4)}
    for fut in as_completed(futures):
        i = futures[fut]
        print(f"Джоба {i}: {fut.result()}, done={fut.done()}")
Джоба 0: 0, done=True
Джоба 1: 1, done=True
Джоба 3: 9, done=True
Джоба 2: 4, done=True
Результаты появляются в порядке готовности. Словарь сохраняет связь Future
с входным аргументом, чтобы понимать, какая джоба закончилась.
Исключения из джоб#
Если джоба завершилась с ошибкой, Future сохраняет исключение. Вызов result()
вызывает это исключение уже в потоке, который получает результат.
Обработаем сбой одной джобы и продолжим собирать остальные результаты:
from concurrent.futures import ThreadPoolExecutor, as_completed

def risky(x: int) -> int:
    time.sleep(0.05)
    print(f"[{threading.current_thread().name}] джоба {x}")
    if x == 3:
        raise ValueError(f"Ошибка на {x}")
    return x * 10

with ThreadPoolExecutor(max_workers=2) as pool:
    futures = {pool.submit(risky, i): i for i in range(5)}
    for fut in as_completed(futures):
        i = futures[fut]
        try:
            print(f"Джоба {i}: {fut.result()}")
        except ValueError as error:
            print(f"Джоба {i}: {error}")
[ThreadPoolExecutor-2_0] джоба 0[ThreadPoolExecutor-2_1] джоба 1
Джоба 1: 10

Джоба 0: 0
[ThreadPoolExecutor-2_1] джоба 2
Джоба 2: 20
[ThreadPoolExecutor-2_0] джоба 3
Джоба 3: Ошибка на 3
[ThreadPoolExecutor-2_1] джоба 4
Джоба 4: 40
as_completed() сообщает о завершении, но сам не пробрасывает
исключение из джобы. Ошибка становится видна через fut.result()
или при проверке fut.exception(); один лишь выход из
with ThreadPoolExecutor(…) её не поднимет.
Часть III. GIL и ошибки синхронизации#
GIL: что именно он защищает#
GIL (Global Interpreter Lock) - блокировка интерпретатора CPython:
при включённом GIL только один поток выполняет Python-код в данном
интерпретаторе в данный момент.
Одна из важных причин существования GIL связана с управлением памятью:
CPython постоянно обновляет счётчики ссылок на объекты, и эти изменения
нужно согласовать между потоками. Как устроены счётчики ссылок и сборщик
мусора (GC, Garbage Collection), разберём дальше в курсе.
PEP 703 добавил сборку CPython без
обязательного GIL (free-threaded). Проверим отдельно возможности сборки и
текущий режим: в такой сборке GIL тоже может быть включён.
import sys
import sysconfig

print("Сборка поддерживает отключение GIL:", bool(sysconfig.get_config_var("Py_GIL_DISABLED")))
print("GIL сейчас включён:", sys._is_gil_enabled())
Сборка поддерживает отключение GIL: False
GIL сейчас включён: True
Python 3.14 сам по себе не означает «без GIL».
Обычная сборка использует GIL. Сборка free-threaded допускает его
отключение. Расширение на C без поддержки этого режима может включить GIL при импорте.
Вычисления: сравним время#
Сначала два одинаковых вычисления последовательно, затем в двух потоках. Число операций в обеих версиях одинаковое.
from concurrent.futures import ThreadPoolExecutor
import time


def cpu_task(n: int) -> int:
    total = 0
    for i in range(n):
        total += i * i
    return total


N = 2_000_000
start = time.perf_counter()
sequential = [cpu_task(N) for _ in range(2)]
seq_time = time.perf_counter() - start

start = time.perf_counter()
with ThreadPoolExecutor(max_workers=2) as pool:
    threaded = list(pool.map(cpu_task, [N] * 2))
par_time = time.perf_counter() - start

print("Результаты совпали:", sequential == threaded)
print(f"Последовательно: {seq_time:.2f} с; два потока: {par_time:.2f} с")
print(f"Ускорение: {seq_time / par_time:.2f}x")
Результаты совпали: True
Последовательно: 0.12 с; два потока: 0.11 с
Ускорение: 1.12x
При включённом GIL Python-код разных потоков не выполняется одновременно на разных ядрах. Два потока обычно не дают ускорения, а переключения добавляют накладные расходы. Без GIL результат зависит от доступных ядер, накладных расходов и самой задачи.
Ожидание ввода-вывода: сравним время#
time.sleep() моделирует ожидание внешнего ресурса. Пока поток спит,
он не держит GIL, и остальные могут работать.
def io_task(delay: float) -> None:
    time.sleep(delay)


start = time.perf_counter()
for _ in range(2):
    io_task(0.5)
seq_time = time.perf_counter() - start

start = time.perf_counter()
with ThreadPoolExecutor(max_workers=2) as pool:
    list(pool.map(io_task, [0.5] * 2))
par_time = time.perf_counter() - start

print(f"Последовательно: {seq_time:.2f} с; два потока: {par_time:.2f} с")
print(f"Ускорение: {seq_time / par_time:.2f}x")
Последовательно: 1.01 с; два потока: 0.51 с
Ускорение: 1.99x
Два ожидания перекрылись: вместо суммы задержек получили примерно одну. CPython также освобождает GIL вокруг многих блокирующих операций ввода-вывода; расширения на C могут освобождать его на время вычислений, например некоторые операции NumPy. Сам факт вызова функции на C этого не гарантирует.
sys.getswitchinterval(): запрос на переключение#
print(f"Интервал переключения: {sys.getswitchinterval() * 1000:.1f} мс")
Интервал переключения: 5.0 мс
Обычно это 5 мс. Значение задаёт желаемый интервал переключения Python-потоков,
а не жёсткий квант времени: текущая операция может задержать передачу GIL,
а следующий поток выбирает планировщик ОС. sys.setswitchinterval() меняет
этот интервал, но не делает программу корректной и не гарантирует порядок.
race condition и data race#
race condition возникает, когда корректность работы зависит от
порядка действий потоков. В примере со счётчиком потоки прочитали старое значение
и записали одинаковое новое: часть обновлений потерялась.
data race — конфликтующий доступ к одной области памяти
из разных потоков: хотя бы один доступ — запись, а обращения не упорядочены
синхронизацией. Два чтения сами по себе не создают data race. В
глоссарии Python
этот термин относится к доступам в машинном коде — например, внутри расширения
на C. Потерянное обновление Python-счётчика само по себе ещё не означает data race.
В CPython с включённым GIL внутренние структуры Python-объектов защищает интерпретатор. Это не делает последовательность действий программы неделимой: между чтением и записью счётчика другой поток может успеть прочитать то же старое значение. PEP 703 отдельно объясняет различие между защитой внутренних данных и корректностью операций.
race condition при работе с защищённой очередью#
У queue.Queue отдельные операции защищены внутренней блокировкой. Но проверка
empty() не резервирует элемент для следующего get_nowait(). Заставим оба
потока проверить очередь до того, как любой из них заберёт единственную джобу:
import queue
import threading

jobs: queue.Queue[str] = queue.Queue()
jobs.put("джоба")
checked = threading.Barrier(2, timeout=2.0)


def check_then_take(name: str) -> None:
    available = not jobs.empty()
    print(f"Поток {name}: в очереди есть джоба — {available}")
    checked.wait()
    if available:
        try:
            item = jobs.get_nowait()
        except queue.Empty:
            print(f"Поток {name}: джобу уже забрал другой поток")
        else:
            print(f"Поток {name}: получена {item}")
            jobs.task_done()


threads = [threading.Thread(target=check_then_take, args=(name,)) for name in ("A", "B")]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join()
Поток A: в очереди есть джоба — True
Поток B: в очереди есть джоба — True
Поток B: получена джоба
Поток A: джобу уже забрал другой поток
Оба увидели непустую очередь, но джобу получил только один. Внутренние данные
очереди не повреждены и доступ к ним согласован; ошибка в предположении, что
результат проверки останется актуальным. Это race condition без data race
на внутренних данных очереди.
Сразу вызываем get_nowait() и обрабатываем queue.Empty как допустимый исход.
Если нужно дождаться джобы, используем get() с таймаутом. Предварительная
проверка empty() не даёт гарантии для следующего извлечения — это отмечено
в документации Queue.empty().
GIL и число инструкций в dis не доказывают атомарность.
Атомарная операция для других потоков выглядит как одно неделимое действие:
они не могут увидеть её частичный результат.
Места переключения зависят от версии и режима CPython, а операция может
вызвать пользовательский код. Всю последовательность «прочитать, проверить,
изменить» выполняем под одной блокировкой. Безопасность отдельных операций
list или dict не гарантирует безопасность их последовательности.
Первый пример с count += 1 может проходить без потерь благодаря особенностям
конкретной версии CPython. Это ещё не доказывает корректность: нужно понять,
какие действия защищены блокировкой и в каком порядке их могут выполнять потоки.
Дедлок (deadlock)#
Два потока захватывают ресурсы в обратном порядке. Barrier заставляет
каждый взять первый Lock до попытки взять второй.
import queue
import threading

lock_a = threading.Lock()
lock_b = threading.Lock()
first_taken = threading.Barrier(2, timeout=2.0)
attempts_finished = threading.Barrier(2, timeout=2.0)
outcomes = queue.Queue()


def inverted_order(name: str, first: threading.Lock, second: threading.Lock) -> None:
    with first:
        first_taken.wait()
        got = second.acquire(timeout=0.05)
        if got:
            second.release()
        outcomes.put((name, got))
        attempts_finished.wait()


threads = [
    threading.Thread(target=inverted_order, args=("A -> B", lock_a, lock_b)),
    threading.Thread(target=inverted_order, args=("B -> A", lock_b, lock_a)),
]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join()

for name, got in sorted(outcomes.get_nowait() for _ in threads):
    print(name, "получил оба ресурса:", got)
A -> B получил оба ресурса: False
B -> A получил оба ресурса: False
Оба получают False: каждый удерживает ресурс, нужный другому.
Второй барьер не даёт первому завершившему ожидание освободить свой Lock
до окончания второй попытки. С обычным acquire() без таймаута они
ждали бы друг друга бесконечно; здесь таймаут позволяет закончить демонстрацию.
Исправление: единый порядок ресурсов#
Оба потока всегда берут A, затем B. Пока один держит A,
другой ещё не может удерживать B - цикл ожидания исчезает.
def same_order(name: str) -> None:
    with lock_a:
        with lock_b:
            print(name, "получил оба ресурса")


threads = [threading.Thread(target=same_order, args=(name,)) for name in ("первый", "второй")]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join()
первый получил оба ресурса
второй получил оба ресурса
Таймаут полезен для отказа от ожидания, но после неудачи нужно освободить уже захваченные ресурсы и решить, что делать дальше. Сам по себе повтор попытки ещё не гарантирует прогресса.
Лайвлок (livelock)#
Потоки не застряли в ожидании навсегда: они освобождают ресурсы и пробуют снова. Но если попытки постоянно совпадают, потоки повторяют действия, не продвигаясь в выполнении задачи.
lock_a = threading.Lock()
lock_b = threading.Lock()
phase = threading.Barrier(2, timeout=2.0)
outcomes = queue.Queue()
ROUNDS = 4


def polite_retry(name: str, first: threading.Lock, second: threading.Lock) -> None:
    completed = 0
    for _ in range(ROUNDS):
        with first:
            phase.wait()
            got = second.acquire(blocking=False)
            phase.wait()
            if got:
                completed += 1
                second.release()
        phase.wait()
    outcomes.put((name, ROUNDS, completed))


threads = [
    threading.Thread(target=polite_retry, args=("первый", lock_a, lock_b)),
    threading.Thread(target=polite_retry, args=("второй", lock_b, lock_a)),
]
for thread in threads:
    thread.start()
for thread in threads:
    thread.join()

for name, attempts, completed in sorted(outcomes.get_nowait() for _ in threads):
    print(f"{name}: попыток {attempts}, успешных {completed}")
второй: попыток 4, успешных 0
первый: попыток 4, успешных 0
Барьеры задают неудачное расписание: оба держат первый ресурс, оба не могут взять второй, оба отпускают и начинают следующий круг. Мы ограничили число кругов четырьмя; без ограничения такой ритм мог бы повторяться бесконечно.
Активность не равна прогрессу. При дедлоке участники ждут друг друга; при лайвлоке они выполняют действия, но не достигают цели. Новые попытки и освобождение блокировок могут продолжаться, хотя ни один поток не продвигается в выполнении задачи.